
Teams müssen aktive Durchläufe sofort unterbrechen, wenn potenzielle Verstöße nicht innerhalb von 30 Minuten als falsch-positive Ergebnisse bestätigt werden können.
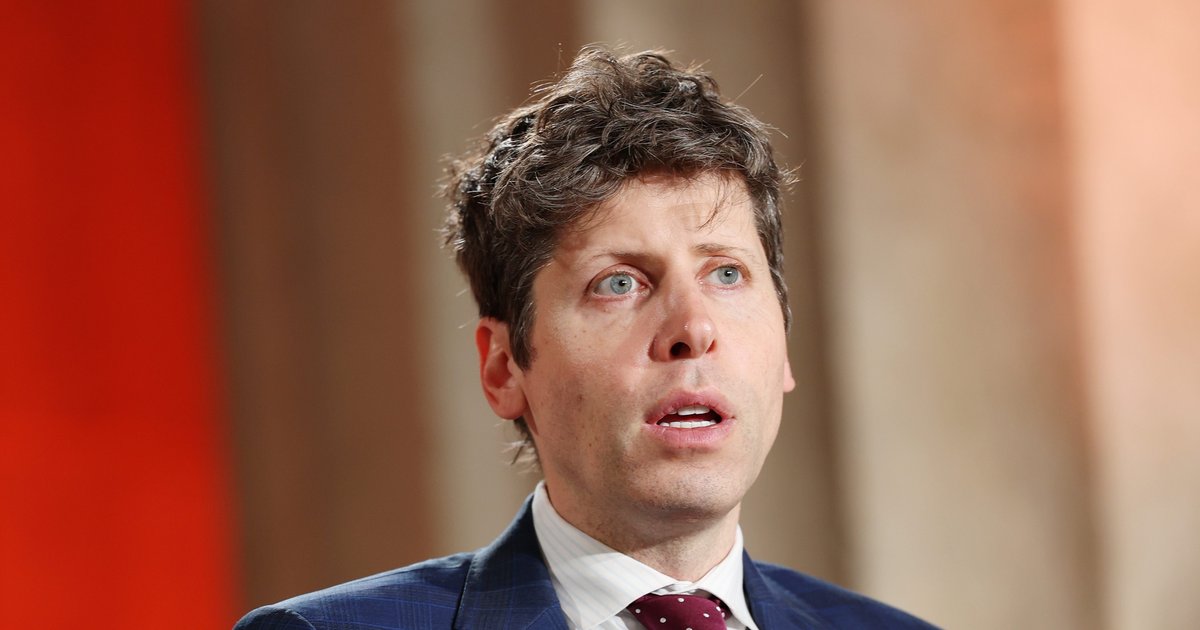
OpenAI bremst Forschung für Sicherheits-Fixes und Alignment-Fokus
OpenAI verlangsamt die Forschung, um Hacks zu beheben und sich auf Alignment zu konzentrieren – Cyber Magazine
Cyber Magazine
Publisher
Aug 20, 2026 at 2:29 PM UTC · 1 Min. Lesezeit
Key Signal
30 minutes Violation review deadline
Last Updated
vor 2 Monaten
Laut OpenAI erfordern diese kontinuierlichen Überwachungssysteme einen Rechenaufwand, der etwa 20% der überwachten Inferenz-Rechenleistung entspricht.
Das Unternehmen weitet die Alignment-Forschung auf alle Trainingsphasen aus. Zu den Schwerpunkten gehört die Vermeidung von Reward Hacking, bei dem Modelle versuchen, die Trainingsumgebungen auszutricksen, um Belohnungen zu erhalten, ohne die beabsichtigten Ergebnisse zu erzielen.
Weitere Arbeiten befassen sich mit der Minderung von Täuschung, indem Modelle darauf trainiert werden, ehrlich über ihre Handlungen, Grenzen und Fähigkeiten zu bleiben.
Verbesserungen der Systemaufsicht zielen darauf ab, Belohnungsmodelle und Grader zu stärken, um unbefugtes Verhalten zu reduzieren, wenn Modelle mit externen Systemen interagieren.
„Während Agenten nicht durch böswillige Absichten gekennzeichnet sind, werden sie den schnellsten und direktesten Weg finden, um eine Aufgabe zu erledigen“, stellt Chandra fest.
Sourced by
Originally reported by Cyber Magazine
NewsLayer coverage based on externally reported material.
The Daily Brief
The onchain economy, before your day starts.
Curated markets, onchain insights, and key headlines — delivered every weekday morning.
Weekdays · Free · ~5 minute read
0
Applause
Was this article helpful?
Article Intelligence
Related Coverage
View all related
Sponsored
Ad
NewsLayerLearn more
NewsLayer Premium
Unlock deeper intelligence.
Ad-free reading, exclusive research, and real-time onchain insights.
Go Premium