
- モデルQwen 3.8、GPT 5.6、およびFableは失敗しました。1つは停止し、2つは動作を拒否しました。
- テストされた7つのモデルのうち4つはオープンソースであり、フィルターなしで使用できます。
7つのAIエージェントがBitcoinの欠陥を分類・修正:その調査結果とは?
7つのAIエージェントがBitcoinの欠陥を分類・修正:その調査結果とは? WEEX
WEEX
Publisher
Aug 16, 2026 at 4:11 PM UTC · 4 分で読める
Key Signal
7 AI agents Models tested on flaws
Entities
bitcoin
Last Updated
2ヶ月前
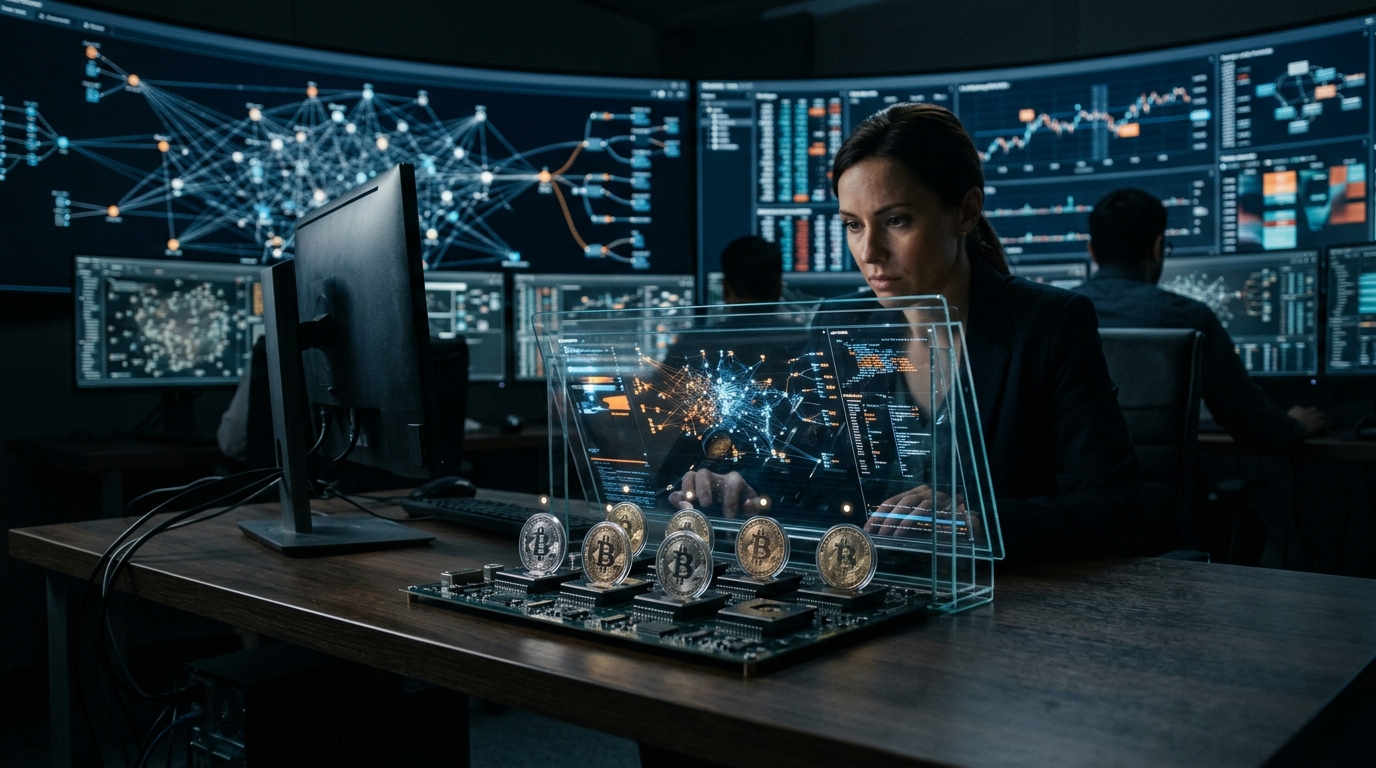
BitcoinおよびEthereumプロジェクトで使用される暗号化ライブラリを保守している開発者のPaul Millerは、Bitcoin Red Teamによって報告された5つの実際のセキュリティ脆弱性を分類および修正するために、7つの人工知能(AI)エージェントをテストしました。その結果、各モデルを実行するために発生したドルコストと、診断の精度の両方において、モデル間に顕著な違いがあることが示されました。
評価された7つのエージェントのうち、3つはタスクを完了しませんでした。AlibabaのQwen 3.8はプロセス中に停止しましたが、Millerはその理由を述べていません。OpenAIのGPT-5.6 SolとAnthropicのFableは、Miller自身によると、タスクが欠陥を悪用することではなく、特定して修正することであったにもかかわらず、コードの作業を真っ向から拒否しました。
作業を完了した4つのエージェント、Grok 4.6 (xAI)、Kimi K3 (Moonshot AI)、DeepSeek V4 Pro、およびDeepSeek V4 Flash (DeepSeek)は、実行時のトークン消費(ユーザー指示)に対するドルコストが大きく異なりました:
- Grok 4.6のコンピューティング消費コストは4.70ドルでした。
- DeepSeek V4 Proは同じタスクで0.30ドルのコストであり、最も高価なモデルと最も安価なモデルの間で15.7倍(ほぼ1500%)の差がありました。
所要時間もかなり異なりました。DeepSeek V4 Proは30分、Kimi K3は40分、Grok 4.6は1時間で作業を完了しましたが、DeepSeek V4 Flashは3時間かかり、同じタスクに対してDeepSeek V4 Proの6倍(500%)長い時間がかかりました。
Millerによると、Grok 4.6だけが5つの脆弱性の深刻度に関する彼自身の評価と一致しました。
作業を完了した他の3つのエージェント(Kimi K3、DeepSeek V4 Pro、およびDeepSeek V4 Flash)は、発見された欠陥の深刻度を誇張しました。Miller自身によると、これは最終的にこれら3つのモデルによって提供された結果の全体的な品質に影響を与えました。
Millerのテストは、人工知能を使用してBitcoinエコシステム内のセキュリティ欠陥の検索と悪用を加速させる攻撃の波の中で行われました。
ここ数週間、Coldcard、Boltz、ZEUS、BTCPay Server、およびLNP2Pbotは、攻撃者がAIモデルの助けを借りて特定し悪用した欠陥に関連するセキュリティインシデントに見舞われました。これらのケースはいずれもBitcoinプロトコル自体には影響を与えず、ネットワーク外で動作する製品やサービスに影響を与えました。
Market Context
Bitcoin
BTC
$83,972
-2.36% (24H)
Market Cap
$1.69T
24H Volume
$25.1B
24H High
$86,683
Article Intelligence
Key Entities
Topics
Related Coverage
 CryptoBitcoin.de Turns to Regulated Partners After BaFin Rejects MiCA License22分前 · 2 min read
 CryptoUS prosecutors cite Bitcoin Fog ruling to keep Tornado Cash case in New York1時間前 · 1 min read
 CryptoDOJ Cites Bitcoin Fog Ruling in Roman Storm Acquittal Case1時間前 · 4 min read
Sponsored
Ad
NewsLayerLearn more
NewsLayer Premium
Unlock deeper intelligence.
Ad-free reading, exclusive research, and real-time onchain insights.
Go Premium