
本日、Amazonは SGLang-Neuron が一般公開され、RadixArkがAnnapurna Labsと協力してリリースしたAWS Deep Learning Containerを通じてアクセス可能になったことを発表しました。SGLang-Neuronを使用すると、現在使用しているものと同じSGLangインターフェースを使用して、AWS Trainium 上でSGLangを用いてモデルをサービングし、強化学習(RL)のロールアウトを生成できます。Trainiumは、大規模なAIトレーニングおよび推論において優れたコストパフォーマンスを提供するAWS AIチップのポートフォリオです。現在、Trainium上でSGLangを実行することは、すでにおなじみのSGLangワークフローに従います。SGLangのサーバーインターフェースを通じてモデルを起動し、同じ生成APIを使用してエンドポイントを呼び出します。そのインターフェースの下では、SGLang-NeuronはネイティブのPyTorch上で動作します。そのout-of-treeプラグイン設計により、TrainiumのサポートとSGLangコアは独立して開発され、より迅速に反復できます。
SGLang-Neuronを使用してAWS Trainium上に最先端AIモデルをデプロイ
SGLang-Neuronを使用して、Amazon Web Services (AWS) のAWS Trainium上に最先端AIモデルをデプロイします。
Amazon Web Services (AWS)
Publisher
Nov 12, 2026 at 10:03 PM UTC · Updated 2日前 · 2 分で読める
SGLangがTrainium上でどのように動作するか
SGLang-Neuronは、SGLangとAWS Trainiumを接続するout-of-treeプラグインです。プラグインをインストールすると、SGLangのプラグインエントリポイントを介してneuronプラットフォームが登録され、SGLANG_PLATFORM=neuron を設定することでサーバー起動時にそれが選択されます。SGLangコアは引き続きAPIサーバー、リクエストのライフサイクル、RadixAttention、およびプレフィックスキャッシュの管理を提供します。プラグインは、Trainium固有のモデル、アテンション、mixture of experts (MoE)、およびグラフランナーを実装しています。
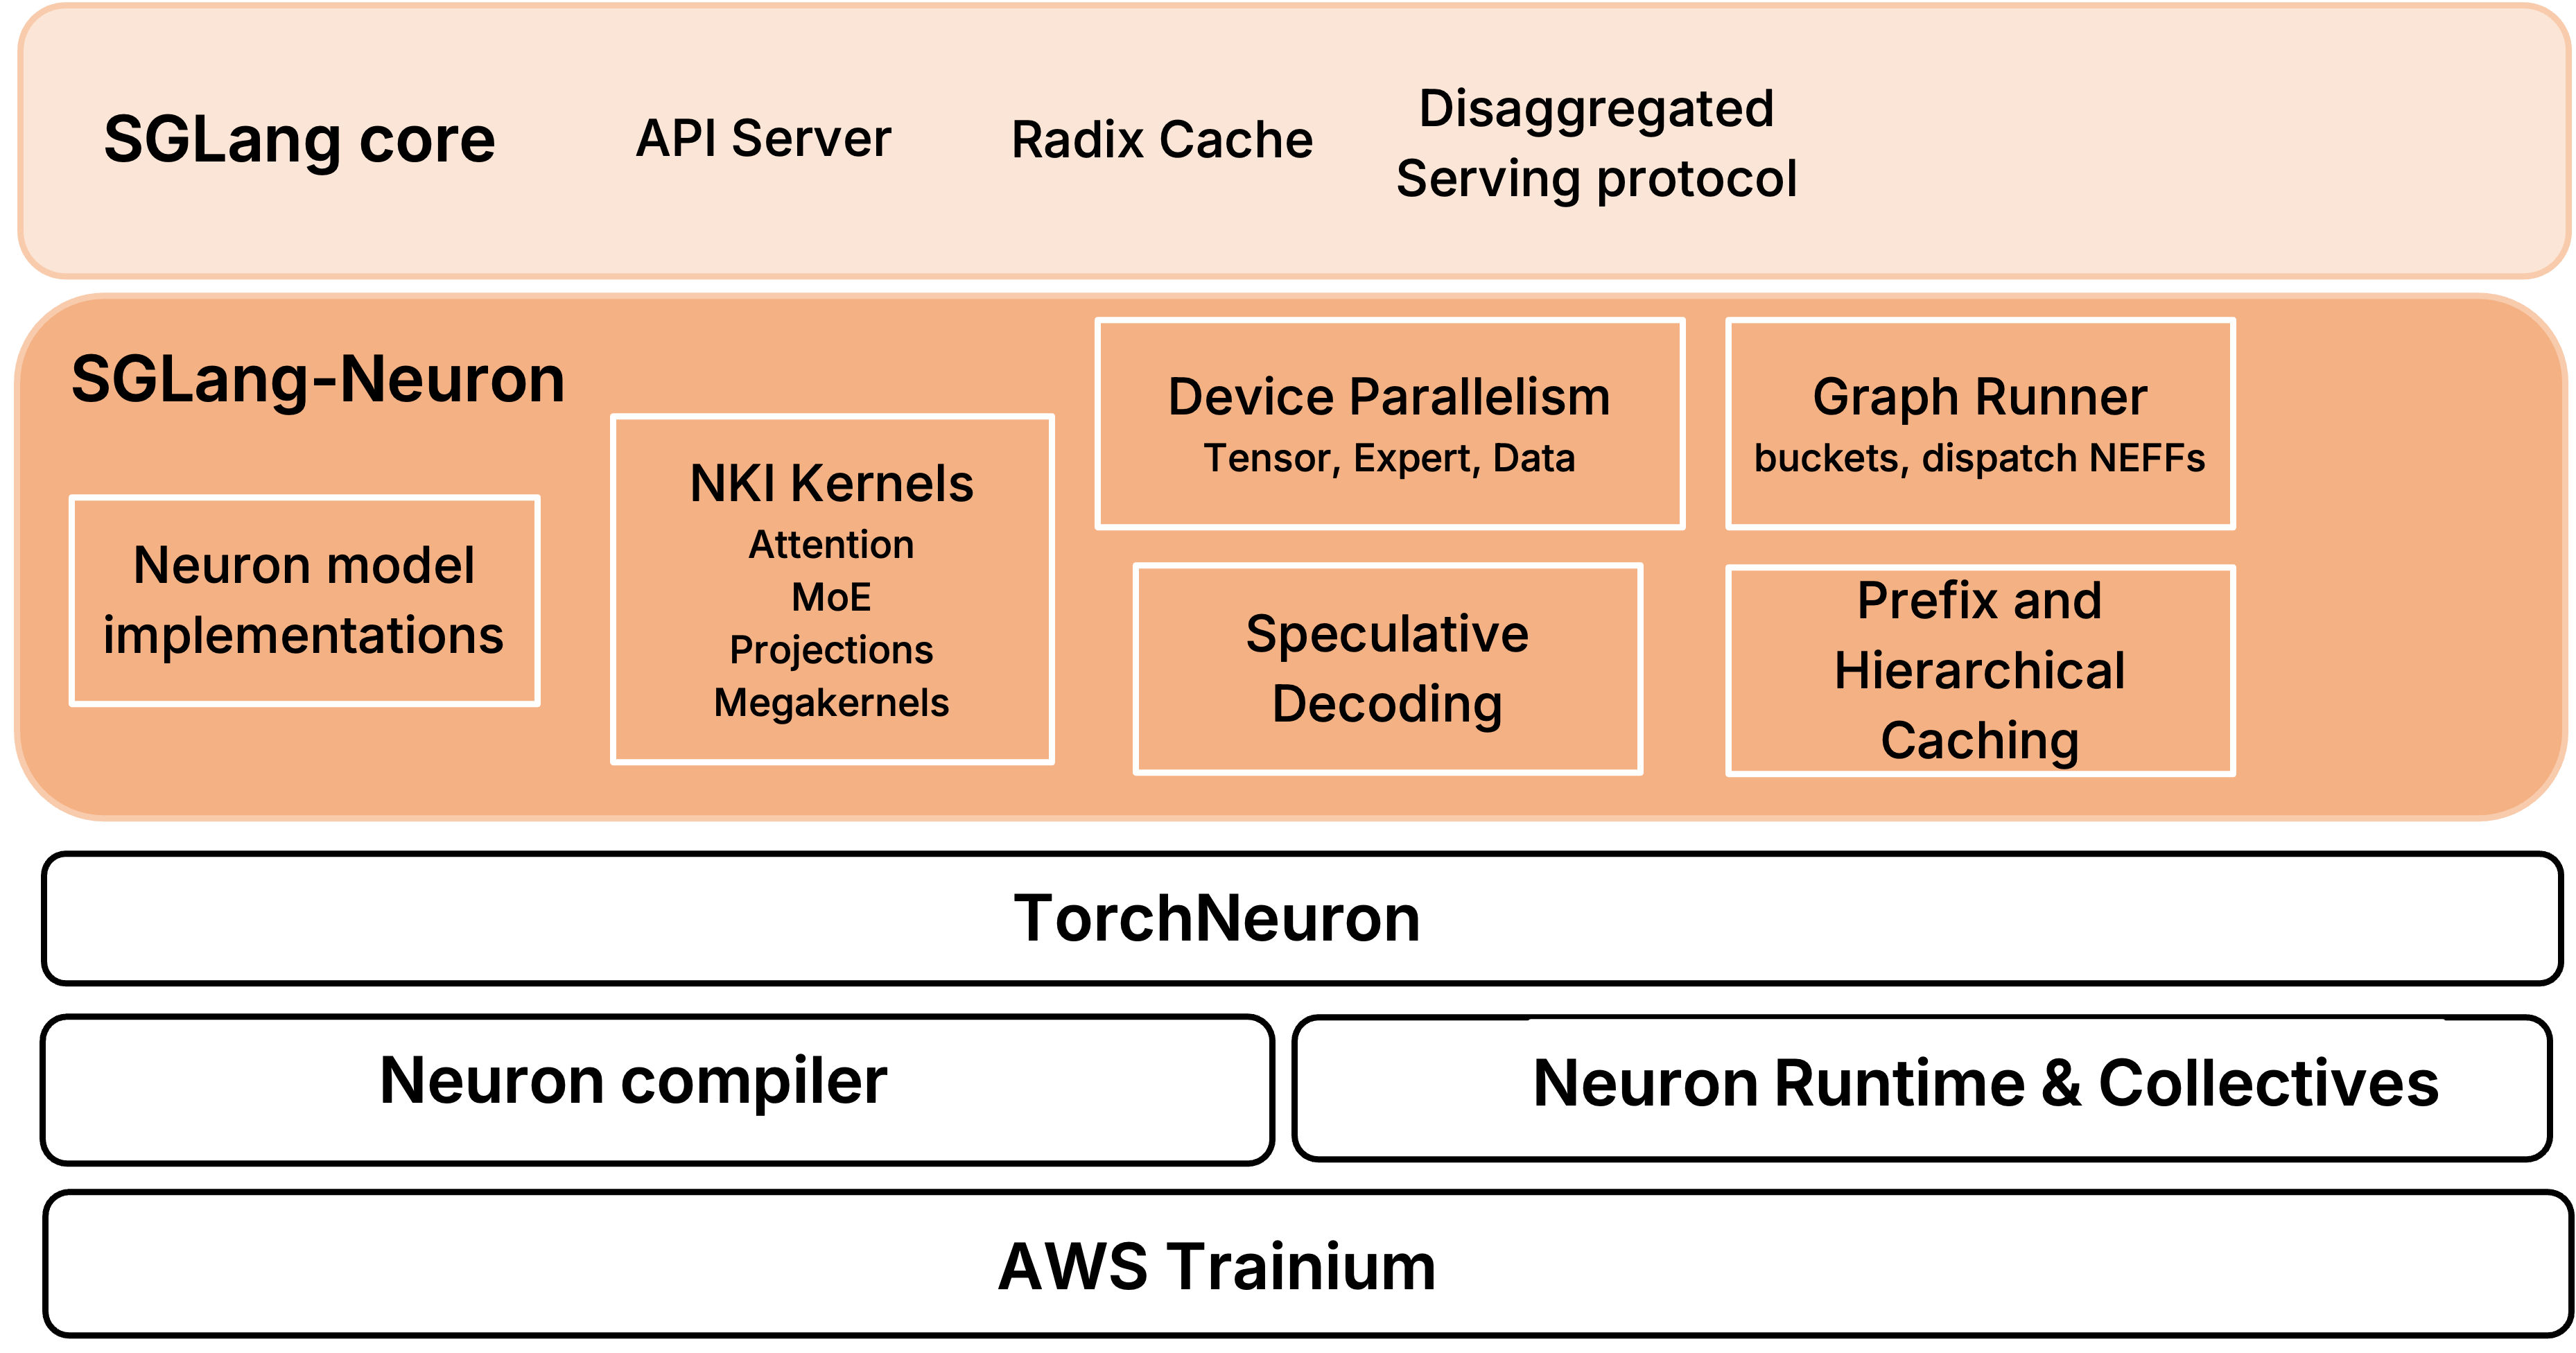
図1:AWS Trainium上のSGLang-Neuron
TorchNeuron は、TrainiumをネイティブのPyTorchデバイスとして登録します。SGLang-Neuronは、モデル実行パスに標準のPyTorchオペレーションを使用し、パフォーマンス向上のために Neuron Kernel Interface (NKI) で記述されたカーネルを組み込んでいます。これらのオペレーションとカーネルを torch.compile を使用して実行可能プログラムにコンパイルし、グラフランナーがサービング中に準備および実行します。
SGLang-Neuronは PD分離(Prefill/Decode disaggregation) もサポートしています。この構成では、プリフィルサーバーがプロンプトのKVキャッシュを計算し、Elastic Fabric Adapter (EFA) 経由の NIXL を使用してデコードサーバーに転送します。その後、デコードサーバーが残りのトークンを生成します。各サーバーは引き続きSGLangのスケジューラーとリクエストライフサイクルを使用し、プラグインがTrainiumの実行とKVキャッシュ転送パスを管理します。
Article Intelligence
Topics
Sponsored
Ad
NewsLayerLearn more
NewsLayer Premium
Unlock deeper intelligence.
Ad-free reading, exclusive research, and real-time onchain insights.
Go Premium