
Grounded Reasoning CupにてAIエージェントをライブ評価
DatabricksのGrounded Reasoning CupでAIエージェントのライブ評価を実施
Databricks
Publisher
Aug 18, 2026 at 8:23 AM UTC · 10 分で読める
Key Signal
63.3% Stanford winning accuracy
Last Updated
2ヶ月前
今年、Databricksは第1回 Grounded Reasoning Cup を開催しました。これは、複雑なエンタープライズ形式の文書コレクションを推論するAIエージェントの能力を評価する、この種のものとしては初のライブAIコンペティションです。新しくリリースされたコーパスを使用してライブコンペティション条件下でエージェントをテストすることにより、Grounded Reasoning Cup はAI評価における最も難しい問いの一つ、つまり「ベンチマークでの性能向上は、類似の現実世界のタスクにどの程度汎用化されるのか?」に答えるために設計されました。
このコンペティションには、米国とカナダ全土から 11 のトップアカデミックチームが集まり、OpenAI、Anthropic、Google DeepMind を含むフロンティアラボからのリソースとメンターシップが提供されました。2ヶ月間にわたり、チームは経済的に価値のあるエンタープライズワークフローを反映するように設計された当社の主力 Grounded Reasoning ベンチマークである OfficeQA 上でエージェントの開発と最適化を行いました。コンペティション当日、彼らはそれらのシステムをリアルタイムで、新しくリリースされた Grounded Reasoning ベンチマークである OfficeQA Pro V2 に適用し、その改善が汎用化されているかどうかをテストする課題に直面しました。
Stanford は 63.3% の精度を達成したシステムで優勝し、平均的なチームを約 +22 ポイント、平均的なフロンティアエージェントのオフラインベースラインを約 +35 ポイント上回りました。上位チームは、文書の事前処理、ターゲットを絞った検索、並列エージェント、構造化されたツールの使用、および検証を通じて、大幅な向上を実証しました。同時に、18.8% の質問はどのチームによっても解決されず、エンタープライズ Grounded Reasoning に依然としてどれほどの向上の余地が残されているかを強調しています。
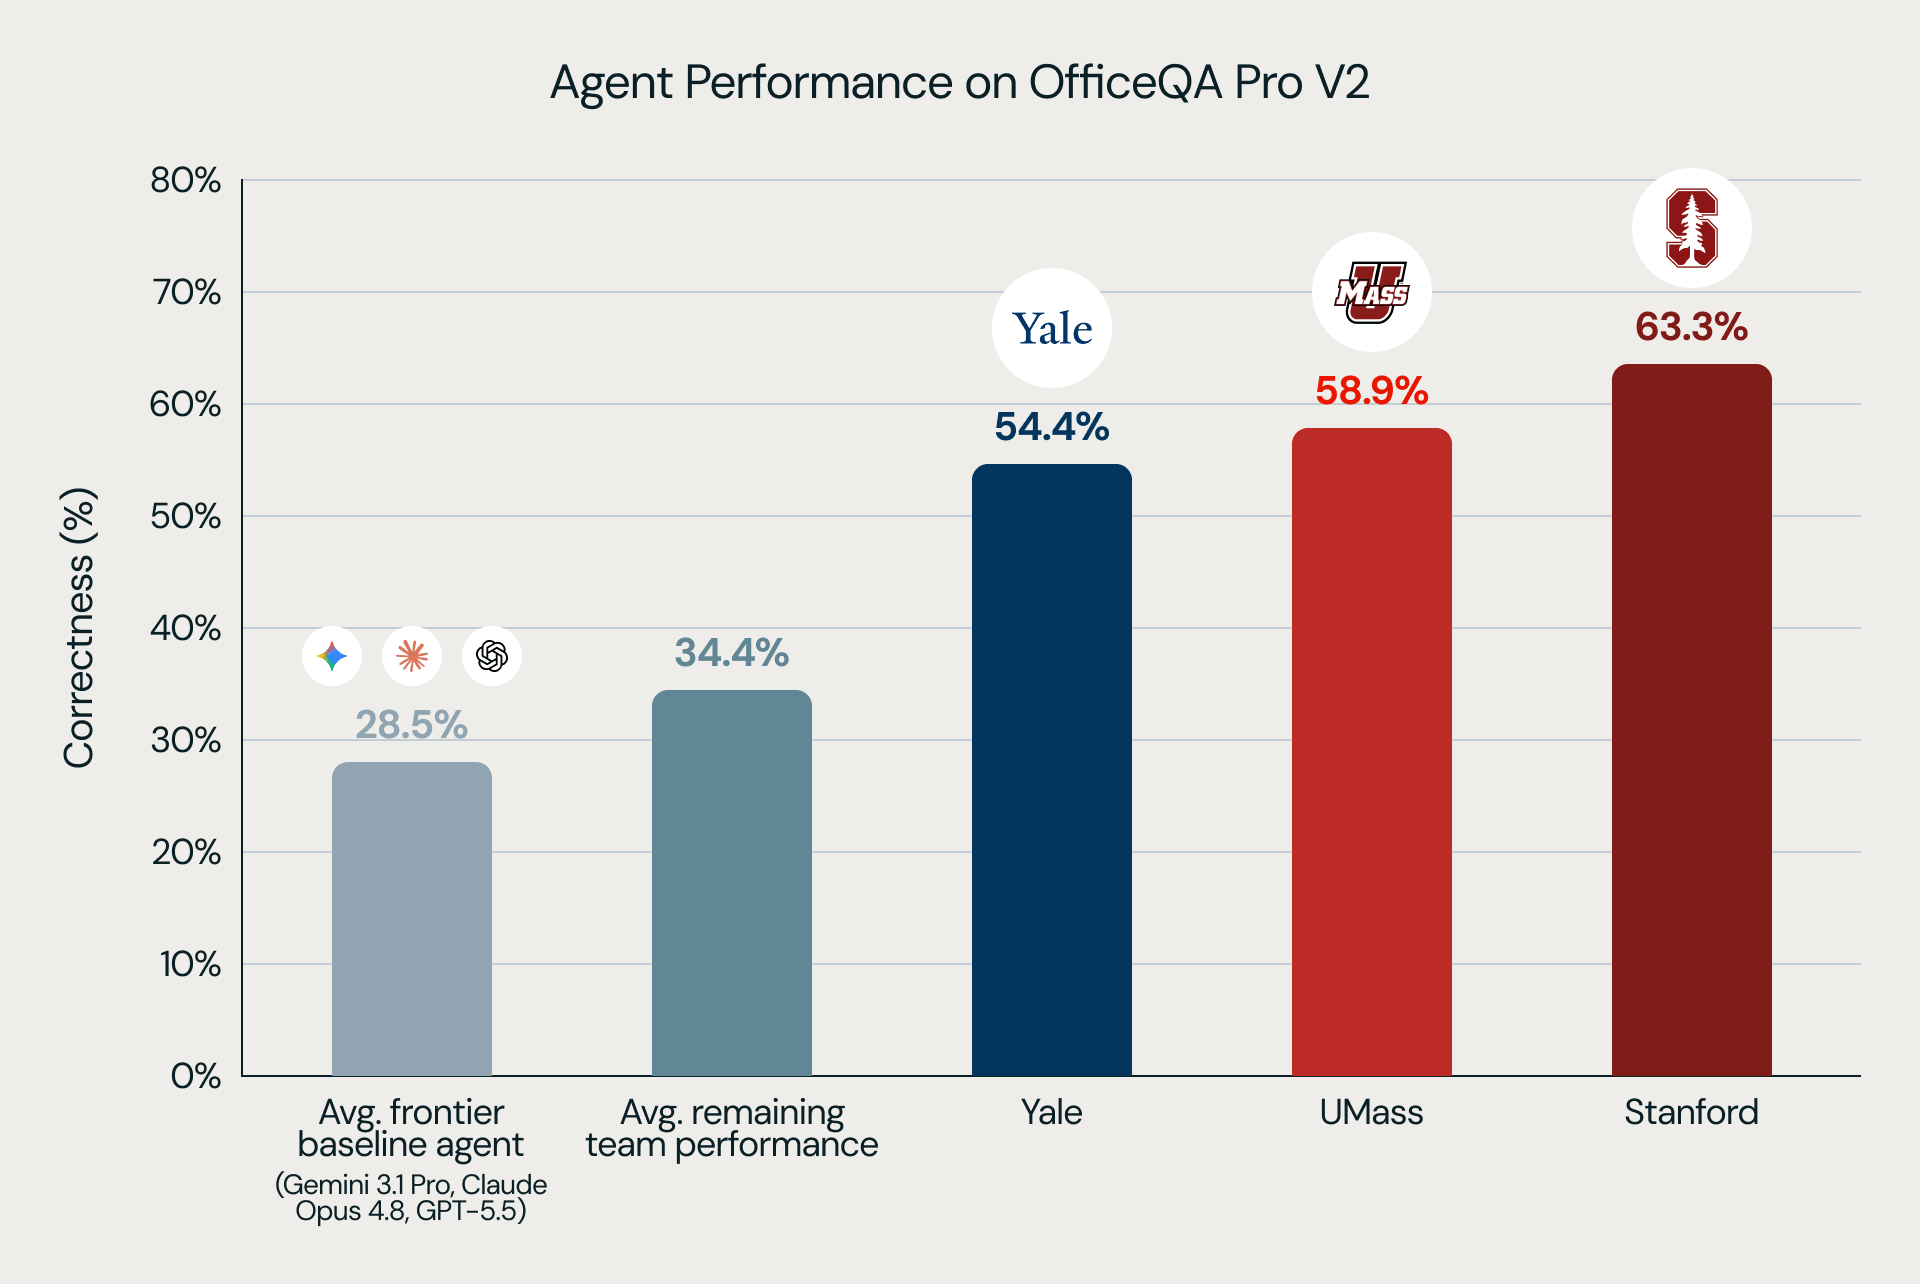
このブログ記事では、コンペティションを振り返り、Grounded Reasoning Cup の優勝チームである Stanford、University of Massachusetts Amherst、Yale によるエージェントの最適化戦略と洞察について説明します。
一般的に、以下のことがわかりました。
- 汎用化には、代表的でホールドアウトされた評価が必要です。 OfficeQA で開発された手法が、常に新しいベンチマークに確実に転用できるとは限りませんでした。これは、ソリューションが新しい例に汎用化されることを保証するために、OfficeQA Pro V2 のようなホールドアウトされたテストセットを利用することの重要性を強調しています。
- エージェントのパフォーマンスは、モデルだけでなくシステム全体に依存します。 同じモデルを使用した最高スコアのチームと最低スコアのチームの平均的な差は 30.4 ポイントでした。パース、検索、ツールの使用、検証、並列処理、および運用インフラのすべてが、エージェントがエンドツーエンドの Grounded Reasoning タスクを正常に完了できるかどうかの分かれ目となりました。
- エンタープライズ Grounded Reasoning は、まだ解決にはほど遠い状態です。 優勝チームでさえ、ベンチマークの検索、パース、分析の要求の多くに苦戦しており、継続的な研究と改善のための実質的な余地が残されています。実務家の皆様には、この取り組みをさらに進めるために、公開されている OfficeQA ベンチマークスイートを使用することをお勧めします。
Article Intelligence
Topics
Sponsored
Ad
NewsLayer Premium
Unlock deeper intelligence.
Ad-free reading, exclusive research, and real-time onchain insights.
Go Premium