Nvidia、Nemotron 3.5 LightningオープンAIモデルを公開
NvidiaがNemotron 3.5 LightningオープンAIモデルを公開(Campus Technology)
Campus Technology
Publisher
Aug 17, 2026 at 8:26 PM UTC · 2 分で読める
Key Signal
30B total model parameters
Last Updated
2ヶ月前
Nvidia、オープンAIモデル「Nemotron 3.5 Lightning」をリリース
Nvidiaは、汎用的な回答エンジンというよりも、長時間実行されるAIエージェントシステム内での高速なワークホース(主戦力)として設計された新しいオープンAIモデル、Nemotron 3.5 Lightningを発表しました。
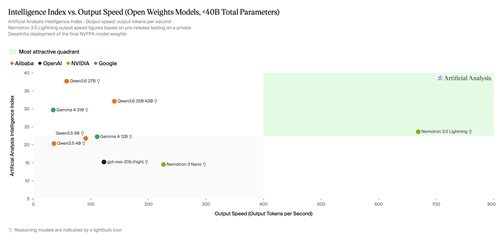
8月11日にリリースされたNemotron 3.5 Lightningは、300億パラメータの混合エキスパート(mixture-of-experts)モデルで、トークンごとに30億パラメータをアクティブにします。Nvidiaによると、最大100万トークンのコンテキストウィンドウをサポートし、同等サイズのモデルの最大4倍の出力速度を実現できます。同社は、OpenMDW-1.1ライセンスの下で、オープンな重み、トレーニングデータ、レシピとともにモデルを提供しています。
Nemotron 3.5 Lightningのリリースにおいてより重要な部分は、Nvidiaがこのようなモデルに期待している役割です。AIエージェントの作業のすべてのステップを大規模なフロンティアモデルに送るのではなく、Nvidiaは異なるモデルが異なるクラスのタスクを処理するシステムを構想しています。
大規模な推論モデルがワークフローの計画や困難な意思決定を処理する一方で、高速な特化型モデルは、エージェントがその計画を実行する際に発生する繰り返しのツール呼び出し、検証、フォーマットタスク、その他のルーチン操作を実行します。AIアプリケーションが単一のプロンプトとレスポンスを超えて、タスクを完了するまでに数十回、あるいはそれ以上のモデル呼び出しを生成する可能性のあるエージェントへと移行するにつれて、この区別はより重要になります。
単一のモデルからモデルのシステムへ
Nvidiaはこのアプローチを「モデルのシステム(system of models)」と表現しています。同社のエンタープライズ向けの発表によると、現代のエージェントはますますモデルのアンサンブルとして動作し、異なるモデルが異なる作業に特化するようになっています。
これにより、AIモデルの選択に関する方程式が変わります。生の能力は引き続き一つの要因ですが、レイテンシ、推論コスト、デプロイ場所、タスクの特化が同じ意思決定の一部となります。困難な推論において最強の選択肢ではないモデルであっても、より迅速に、かつ十分な精度で完了できるのであれば、大量の狭いタスクに対しては依然として理にかなっている可能性があります。
Nvidiaは、Lightningと併せてNeMo Switchyardをリリースすることで、この考えを強化しています。このオープンソースのルーティングライブラリは、品質、レイテンシ、コストなどの要件に基づいて、個々のリクエストを異なるモデルに振り分けるように設計されています。Nvidiaは、組織がリクエストを行うアプリケーションを書き換えることなく、オープン、プロプライエタリ、Nvidiaのモデルを独自に組み合わせて作業をルーティングできると述べています。
この組み合わせは、モデルの選択が一度限りのプラットフォームの選択ではなく、実行時の決定となるAIアーキテクチャを示唆しています。エージェントを構築するチームは、すべてのリクエストに対応するために一つのモデルを選択するのではなく、どのモデルがどのタスクを処理するかを含め、ワークフロー全体のパフォーマンスを評価することが増えるでしょう。
最大知能よりもスピード
Lightningの設計はこのトレードオフを反映しています。その混合エキスパートアーキテクチャは、各トークンに実際に使用されるパラメータ数よりも大きな総容量をモデルに提供し、一方でNvidiaは推論効率を高めるために、マルチトークン予測、投機的デコード、およびNVFP4量子化チェックポイントも追加しました。
Sourced by
Originally reported by Campus Technology
NewsLayer coverage based on externally reported material.
The Daily Brief
The onchain economy, before your day starts.
Curated markets, onchain insights, and key headlines — delivered every weekday morning.
Weekdays · Free · ~5 minute read
0
Applause
Was this article helpful?
Article Intelligence
Topics
Sponsored
Ad
NewsLayer Premium
Unlock deeper intelligence.
Ad-free reading, exclusive research, and real-time onchain insights.
Go Premium