
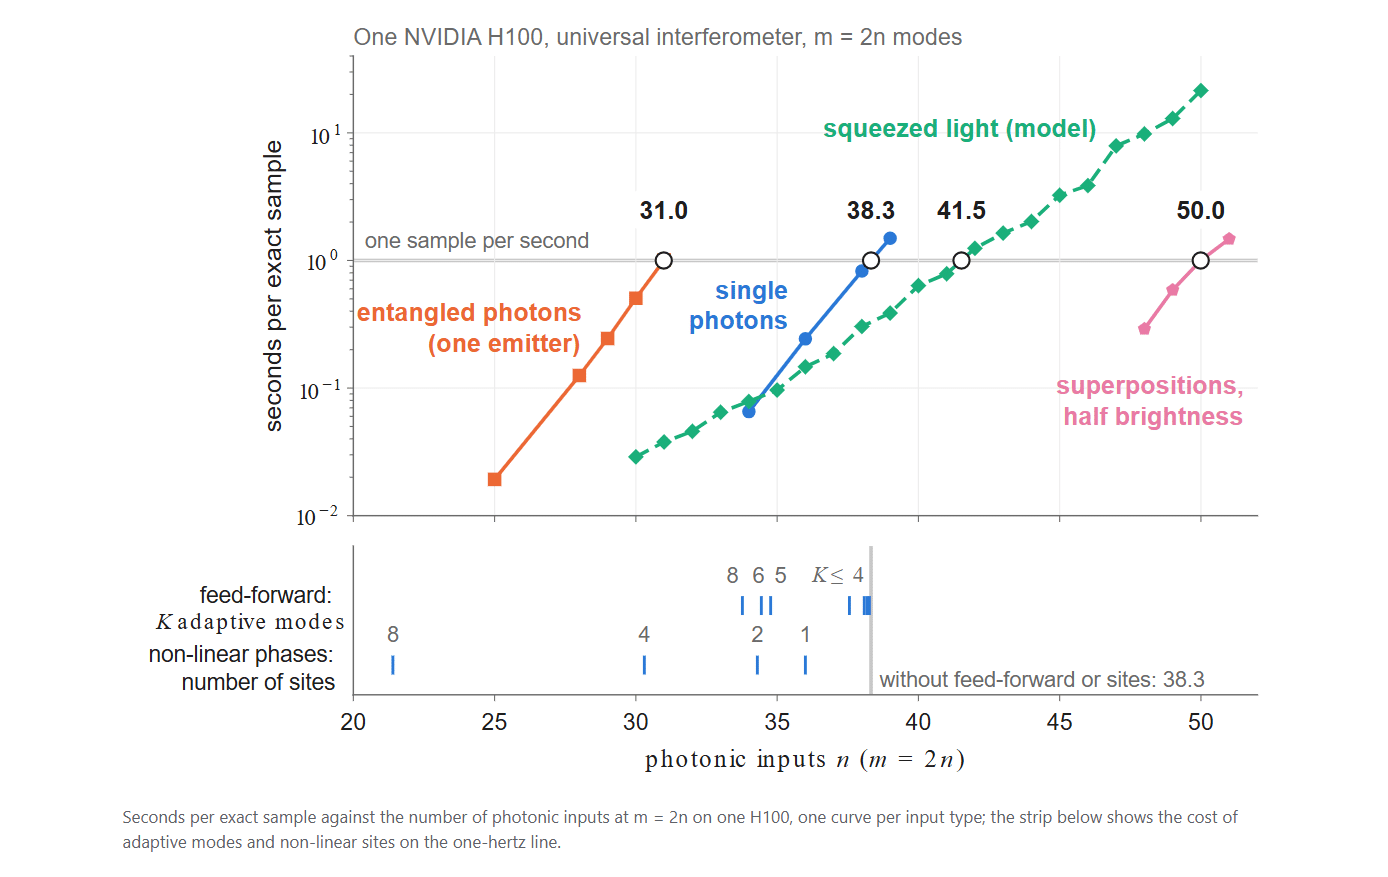
Pesquisadores da Quandela, CNRS e NVIDIA publicaram um estudo de benchmarking definindo uma "fronteira de simulabilidade" padronizada para medir quando os processadores quânticos fotônicos superam a simulação clássica exata em uma única GPU NVIDIA H100 PCIe. Detalhado em um preprint técnico e apoiado pela biblioteca de GPU de código aberto photonic-engines, o trabalho substitui limiares de literatura díspares variando de 50 a 98 fótons por uma métrica de rendimento unificada: o número de entradas fotônicas em que o amostrador clássico exato mais rápido sustenta uma amostra por segundo em interferômetros universais com o dobro de modos ópticos em relação às entradas (m = 2n).
Quandela e NVIDIA definem benchmark de fronteiras de simulabilidade quântica fotônica em GPUs H100
Quandela e NVIDIA definem benchmark de fronteiras de simulabilidade quântica fotônica em GPUs H100 – Quantum Computing Report
Quantum Computing Report
Publisher
Nov 18, 2026 at 5:43 PM UTC · Updated há uma hora · 3 min de leitura
Key Signal
~10^16 GPUs GPUs for 100 inputs
Last Updated
há uma hora
| Amostragem Fotônica Exata e Fronteiras de Recursos em uma GPU NVIDIA H100 (m = 2n) | ||
|---|---|---|
| Modalidade Fotônica / Restrição de Recurso | Fronteira de Amostragem Exata de 1 Hz (n*) | Principais Descobertas de Escalonamento e Arquitetura |
| Emissores Quânticos Emaranhados | 31.0 entradas fotônicas (medido) | O emaranhamento de estado de produto de matriz adiciona um overhead de ~n/2; trens tick-by-tick atingem 1 Hz em ~21–22 emissores. |
| Fótons Únicos (Entradas de Fock) | 38.3 entradas fotônicas (medido) | Base exponencial β = 1.82; 8 GPUs H100 adicionam +3.5 entradas, enquanto 16,384 GPUs adicionam +16.2 entradas. |
| Luz Espremida (0.5 fótons/squeezer) | 41.5 entradas fotônicas (modelado, S = 104) | O crivo de pares loop-hafnian escala como 2N/2 em fótons detectados; cai para 9.7 entradas em 1.5 fótons/squeezer. |
| Superposições Coerentes (α = π/4) | 50.0 entradas fotônicas (medido) | A coerência quântica reduz a fronteira em 14.2 entradas em comparação com fótons com perdas incoerentes (64.2). |
| Memória e Precisão de Ponto Flutuante | 13 fótons (RAM) / ~55–62 (fp64) | A simulação forte atinge o limite de 80 GiB HBM2e em 13 fótons; a precisão dupla falha perto de 55 fótons únicos / 62 espremidos. |
Como a complexidade da amostragem exata cresce exponencialmente com as contagens de fótons detectados, o paralelismo de hardware produz apenas ganhos logarítmicos, exigindo aproximadamente 1016 GPUs para atingir 100 entradas de fóton único sem avanços algorítmicos. Inversamente, a substituição do algoritmo de amostragem de bósons de Clifford e Clifford de 2018 por sua formulação de saída colapsada de 2020 e kernels CUDA personalizados elevou a fronteira de fóton único de 32.5 para 38.3 entradas em hardware idêntico, enquanto a adição de um local de fase não linear (φ = π/2) reduziu a fronteira em 2.2 entradas e o feed-forward no meio do circuito em até três modos a deslocou em no máximo 0.2 entradas.
Article Intelligence
Related Coverage
 QuantumIQM Researchers Benchmark Projected Quantum Kernels Across 45 Qubits Using Cross-Device Referee-Challenger Protocolhá 21 horas · 1 min read
 QuantumQatar and France Sign Bilateral Letter of Intent on Digital Cooperation Highlighting Shared Quantum Ambitionshá 7 horas · 2 min read
 QuantumQuEra Computing and Berkeley Lab Publish Nature Study of Quantum Dynamics on Up to 180 Qubitshá 8 horas · 4 min read
Sponsored
Ad
NewsLayerLearn more
NewsLayer Premium
Unlock deeper intelligence.
Ad-free reading, exclusive research, and real-time onchain insights.
Go Premium