
在 Grounded Reasoning Cup 现场评估 AI 智能体
在 Databricks 的 Grounded Reasoning Cup 现场评估 AI 智能体
Databricks
Publisher
Aug 18, 2026 at 8:23 AM UTC · 10 分钟阅读
Key Signal
63.3% Stanford winning accuracy
Last Updated
2 个月前
今年,Databricks 举办了首届 **Grounded Reasoning Cup,这是一场首创的实时 AI 竞赛**,旨在评估 AI 智能体在复杂的企业级文档集上进行推理的能力。通过在实时竞赛条件下对新发布的语料库测试智能体,Grounded Reasoning Cup 旨在帮助回答 AI 评估中最难的问题之一:基准测试上的性能提升如何很好地泛化到类似的现实世界任务中?
此次竞赛汇聚了来自 U.S. 和 Canada 的 11 支顶尖学术团队,并配备了来自 OpenAI、Anthropic 和 Google DeepMind 等前沿实验室的资源和指导。在两个月的时间里,各团队在 OfficeQA(我们旗舰级的落地推理基准测试,旨在反映具有经济价值的企业工作流程)上开发并优化了他们的智能体。在比赛当天,他们面临的挑战是将这些系统实时应用于新发布的落地推理基准测试 OfficeQA Pro V2,该测试旨在检验他们的改进是否具有泛化性。
Stanford 以 63.3% 的准确率获胜,比团队平均水平高出约 +22 分,比平均前沿智能体离线基准高出约 +35 分。顶尖团队通过文档预处理、针对性检索、并行智能体、结构化工具使用和验证展示了显著的收益。同时,18.8% 的问题没有任何团队能够解决,这凸显了企业落地推理仍有很大的提升空间。
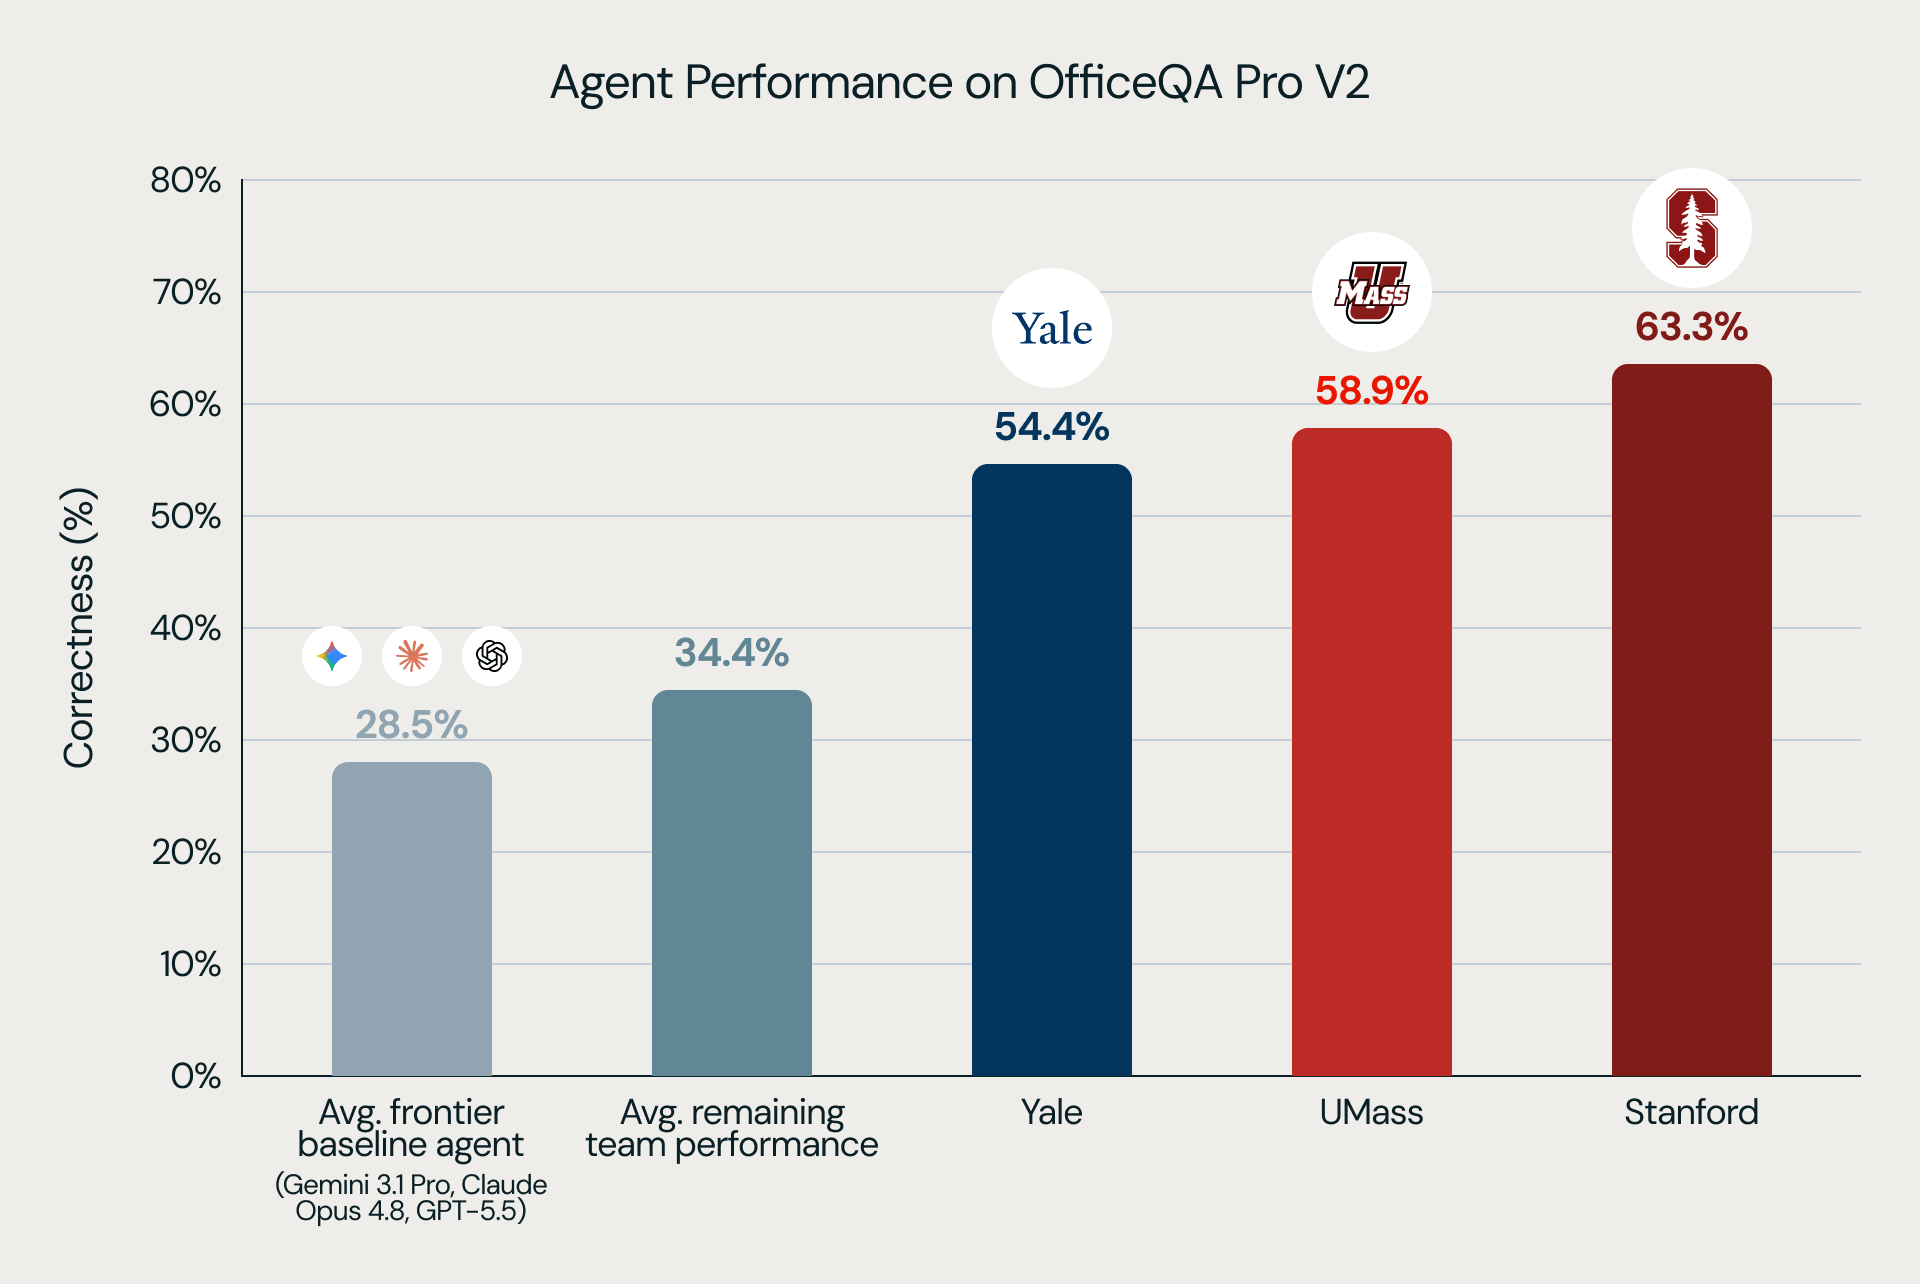
在这篇博文中,我们将回顾竞赛,并探讨来自 Grounded Reasoning Cup 获胜团队:Stanford、UMass Amherst 和 Yale 的智能体优化策略和见解。
总的来说,我们发现:
- 泛化需要具有代表性的留出评估。 在 OfficeQA 上开发的技术并不总能可靠地迁移到我们的新基准测试中。这强调了利用像 OfficeQA Pro V2 这样的留出测试集的重要性,以确保解决方案能泛化到新示例中。
- 智能体性能取决于整个系统,而不仅仅是模型。 使用相同模型的最高分团队与最低分团队之间的平均差距为 30.4 分。解析、检索、工具使用、验证、并行化和运营基础设施都在智能体是否能成功完成端到端落地推理任务中起到了决定性作用。
- 企业落地推理仍远未解决。 即便是获胜团队在处理基准测试中的许多检索、解析和分析需求时也感到吃力,这为持续的研究和改进留下了巨大的空间。我们鼓励从业者使用公开的 OfficeQA 基准测试套件继续推进这项工作。
竞赛设置
Grounded Reasoning Cup 的目标是汇聚顶尖学术团队,开发可泛化的落地推理方法——这是企业环境中的一项常见任务,涉及使用来自大型(通常是专有的)文档集的证据来回答复杂问题。
由 2-4 人组成的代表其学术机构的团队与来自 OpenAI、Anthropic 或 Google DeepMind 的行业合作伙伴配对,后者在整个开发期间提供模型访问权限和指导。团队有大约两个月的时间使用他们认为合适的任何方法构建智能体,唯一的约束是必须专门使用其合作伙伴实验室的模型系列来驱动其智能体。在此期间,他们使用 OfficeQA 基准测试来评估他们认为可以泛化到类似落地推理任务的新技术。
Article Intelligence
Topics
Sponsored
Ad
NewsLayer Premium
Unlock deeper intelligence.
Ad-free reading, exclusive research, and real-time onchain insights.
Go Premium