
内部简报
Google 研究人员提议利用错误记录改进计算后的量子结果
简报:错误甚至能在量子计算机内置的纠正系统中存续,导致研究人员得到的结果虽然看起来可靠,但实际上仍有偏差。现在,Google Quantum AI 的研究人员在 arXiv 上的一篇预印本研究中报告了一种“先测量,后缓解”的方法,该方法利用计算过程中保存的错误记录来减少 [...]
Matt Swayne
Publisher The Quantum Insider
Oct 13, 2026 at 1:05 PM UTC · Updated 2 天前 · 7 分钟阅读
Key Signal
1,000-fold simulation error suppression
Last Updated
2 天前
- Google Quantum AI 的研究人员开发了一种方法,利用保存的纠错记录来减少计算后量子结果中的失真,在模拟中实现了超过 1,000 倍的抑制。
- 该方法将快速解码器与更精确的离线解码器进行比较,并调整每次测量对答案的贡献程度,从而避免了单独的校准实验或对量子电路的更改。
- 结果依赖于简化的噪声模拟,该方法需要额外的测量,并且需要在现实条件和量子硬件上进行进一步测试。
即使是量子计算机内置的纠错系统也可能无法完全消除错误,导致研究人员得到的结果看起来可靠,但仍存在轻微偏差。
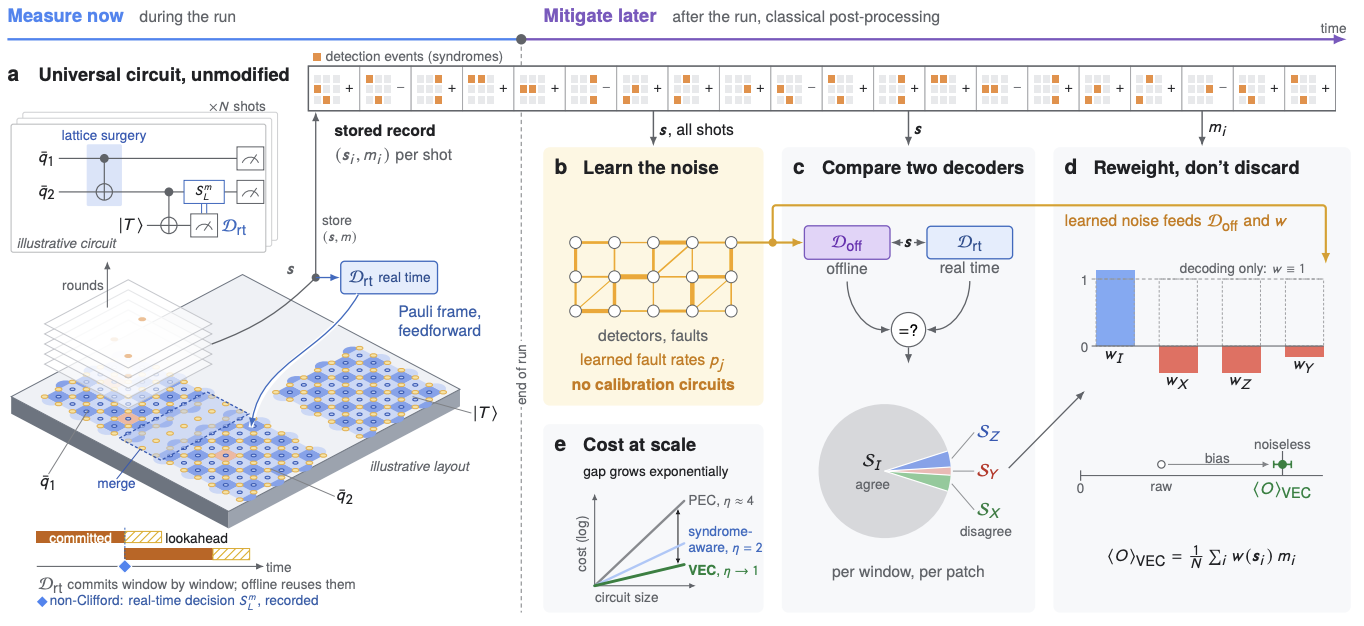
现在,Google Quantum AI 的研究人员在 arXiv 的一项预印本研究中报告了一种“现在测量,稍后缓解”的方法,该方法利用计算过程中保存的错误记录,在模拟中将剩余失真减少了 1,000 倍以上。
这种被称为虚拟错误消除(virtual error cancellation)的方法在量子计算结束后,将部分工作转移到传统计算机上。它利用量子系统已经收集的信息来调整单个测量结果对最终答案的贡献程度。
根据这项研究,该方法避免了用于测量噪声的单独实验,且不需要更改运行计算的量子电路。不过,它仍然需要付出代价。研究人员必须重复测量以产生精确的答案,且其增益尚未在量子硬件上得到证实。
研究结果指向了一种从早期容错量子计算机中获得更准确估计的可能途径。这些机器被设计成尽管存在错误也能继续运行,但其保护仍将是不完美的,尤其是在可用量子比特(qubits)数量有限的情况下。
双重检查
量子计算机对干扰(有时也被称为“噪声”)异常敏感。它们的基本信息单位——量子比特,在计算过程中可能会丢失信息或表现异常。
纠错通过将信息分散在多个物理量子比特上来解决这个问题。这些量子比特共同组成了一个受保护的单位,称为逻辑量子比特。计算机会反复检查是否存在出错的迹象。
这些检查会产生错误记录,称为校验子(syndromes)。一个名为解码器(decoder)的传统计算程序会读取这些记录,并决定哪种修正最有可能奏效。
这个过程可能会遗漏错误,有时现有的证据是模糊的,或者解码器选择了错误的修正。错误随后会波及受保护的信息并影响计算。
一种对策是构建更大的量子比特组以提供更强的保护。这可以减少错误,但也会增加执行有用工作所需的硬件。
Google 团队研究了另一种方案。与其试图在计算过程中防止每一个残留错误,研究人员可以利用保存的记录来减轻事后对答案的影响。
量子计算通常涉及多次重复实验并将测量结果组合成一个估计值。虚拟错误消除改变了每个结果对该估计值的贡献程度。
一些结果获得的权重略高,另一些则获得负权重,这意味着它们的贡献被减去了。研究指出,通过合适的权重,剩余的错误在平均意义上可以相互抵消。
该方法改进了多次运行产生的估计值。它并不能使每一次单独的运行都正确,也不能在计算完成后修复量子态。
快速决策,随后严密审查
根据研究,该方案依赖于两个分工不同的解码器。
Article Intelligence
Related Coverage
 ResearchSoftware advance brings complex quantum simulations to standard computers8 小时前 · 1 min read
 QuantumSAXON Q and Fraunhofer IWU Demonstrate Record 3-Qubit Grover Search on Commercial Room-Temperature Quantum Computer4 小时前 · 1 min read
 QuantumINmune Bio and QCi Combine Quantum Computing and AI to Study Drug Applications8 小时前 · 4 min read
Sponsored
Ad
NewsLayerLearn more
NewsLayer Premium
Unlock deeper intelligence.
Ad-free reading, exclusive research, and real-time onchain insights.
Go Premium